20 - Computação Gráfica
A computação gráfica estuda como representar, transformar e exibir objetos, cenas e fenômenos visuais por meio de modelos matemáticos e algoritmos. Ela conecta álgebra linear, geometria, óptica, arquitetura de hardware e percepção humana para resolver um mesmo problema central: como converter uma descrição abstrata do mundo em uma imagem significativa para quem observa. Neste capítulo, esse percurso será acompanhado desde as transformações geométricas e sistemas de coordenadas até projeção, câmera virtual, modelagem de malhas, pipeline de renderização, texturas, aliasing e visualização, sempre com a ideia de mostrar como cada etapa prepara a seguinte dentro da construção de uma cena digital.
A computação gráfica nasceu do encontro entre geometria, óptica e engenharia de hardware. Um marco histórico importante foi o Sketchpad, desenvolvido por Ivan Sutherland em 1963. Ele não era apenas um “programa de desenho”: mostrou que um computador podia exibir formas geométricas em tela, permitir interação direta com caneta de luz e manter relações geométricas entre objetos, como paralelismo e coincidência. Em outras palavras, ajudou a consolidar a ideia de que a tela podia ser um espaço de manipulação visual, não apenas de saída textual.
Nas décadas seguintes, a área evoluiu junto com o hardware de exibição. Monitores CRT varriam a tela com feixes de elétrons e apresentavam limitações de estabilidade, brilho e nitidez em comparação com tecnologias posteriores. Depois vieram LCDs, LEDs e OLEDs, que melhoraram resolução, contraste, fidelidade de cor, espessura dos dispositivos e eficiência energética. Ao mesmo tempo, o processamento de imagens deixou de depender apenas da CPU e passou a explorar placas gráficas especializadas, framebuffers e pipelines cada vez mais programáveis. Hoje, a mesma base matemática que movia experimentos acadêmicos sustenta interfaces, jogos, CAD, simuladores, realidade aumentada e visualização científica.
Essa evolução também exigiu camadas de software cada vez mais sofisticadas. Nos primeiros anos, programar gráficos significava lidar de modo muito próximo com o hardware ou com rotinas bastante específicas de cada sistema. Com o tempo, surgiram bibliotecas e padrões que abstraíram operações fundamentais, como desenhar primitivas, aplicar transformações, controlar câmeras, definir materiais e enviar dados à GPU. Em diferentes momentos, interfaces como GKS, PHIGS, OpenGL, Direct3D e, mais tarde, Vulkan e bibliotecas de apoio como SDL e GLFW ajudaram a organizar esse trabalho em níveis de abstração mais reutilizáveis.
Na programação de jogos, essa mudança foi decisiva. Em vez de escrever cada rotina gráfica do zero, desenvolvedores passaram a trabalhar sobre APIs, motores e bibliotecas que encapsulam partes do pipeline, tratamento de janelas, entrada de dados, sincronização com a GPU, renderização de sprites ou malhas 3D, iluminação e composição de cena. Isso alterou o foco da programação: menos esforço em controlar detalhes elétricos ou específicos do dispositivo, mais esforço em modelar mundos, física, animação, câmera, interface e lógica de jogo. Ainda assim, os conceitos desta seção continuam no centro do processo, porque qualquer motor gráfico continua dependendo de coordenadas, transformações e representação geométrica consistente.
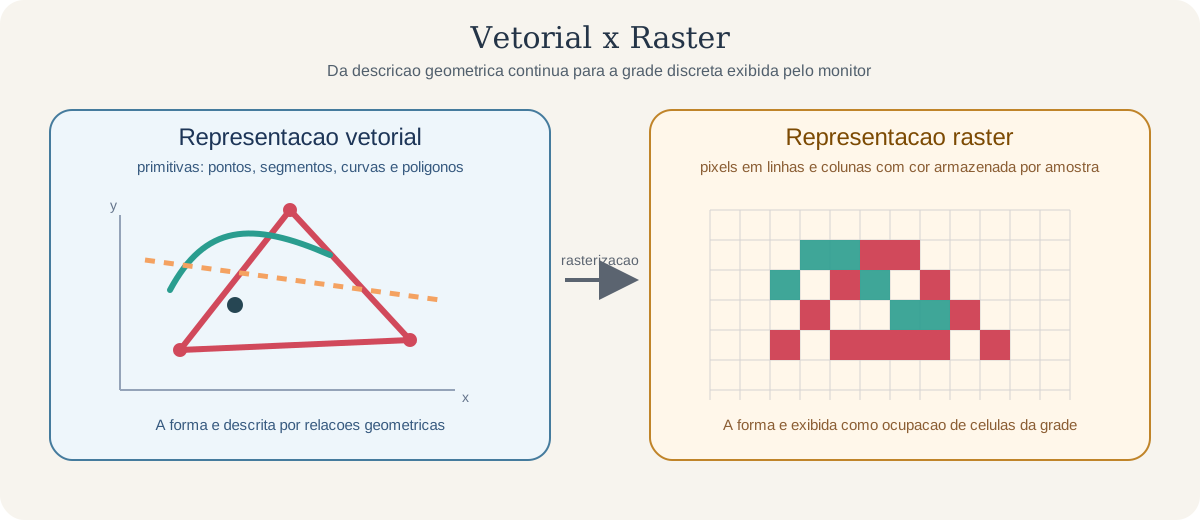
Em um monitor, a imagem final é discreta: ela aparece como uma grade de pixels, isto é, pequenas células organizadas em linhas e colunas. Cada pixel é, na prática, uma amostra visual da cena. Em muitas telas, ele ainda é composto por subpixels vermelho, verde e azul, cuja combinação controlada de intensidade produz a cor percebida. A cena geométrica descrita por equações é contínua, mas a tela é finita e amostrada; grande parte dos problemas de computação gráfica surge justamente dessa passagem do contínuo para o discreto.
O modelo de cor mais usado em monitores é o RGB, um modelo aditivo: adicionamos intensidades de vermelho, verde e azul para formar outras cores. Assim, \( (255, 255, 255) \) representa branco e \( (0, 0, 0) \) representa preto em uma codificação usual de 8 bits por canal. Há outros modelos importantes, como CMYK na impressão e HSV/HSL em interfaces de edição, mas para dispositivos emissivos o RGB é a referência central. Em pipelines modernos, além dos três canais principais, frequentemente aparece um quarto canal, o alfa, usado para representar opacidade. Um valor alfa alto indica que o fragmento é mais opaco; um valor baixo indica que ele é mais transparente. Isso é fundamental em efeitos como vidro, fumaça, interfaces sobrepostas e composição de camadas.
Também houve uma evolução importante na forma de representar e renderizar cores. Monitores antigos trabalhavam com gamas, brilhos e contrastes mais limitados; sistemas atuais lidam melhor com calibração, gerenciamento de cor, alta densidade de pixels e até faixas de alto alcance dinâmico, como HDR. Isso significa que a renderização de cores não depende apenas de “escolher um RGB”, mas também de entender como o dispositivo interpreta intensidades, como o olho humano percebe luminância e como preservar contraste e detalhe ao exibir a imagem.
Antes de os framebuffers raster se tornarem padrão, parte importante da pesquisa em computação gráfica estava voltada à exibição direta de formas geométricas por computador. Em vez de pensar a tela como uma matriz de pixels, muitos sistemas iniciais tratavam o problema como desenho de linhas e curvas sobre dispositivos vetoriais, próximos da lógica de osciloscópios e monitores de varredura vetorial. Isso fazia sentido em aplicações de engenharia e CAD, nas quais o objetivo principal era exibir segmentos, contornos e diagramas com precisão geométrica. Desse contexto histórico nasce a distinção entre descrição vetorial de objetos e imagem rasterizada.
Objetos vetoriais são descritos por primitivas geométricas, como pontos, segmentos, curvas e polígonos. Já uma imagem raster, também chamada de imagem matricial ou bitmap, é uma grade de amostras em que cada posição armazena informação de cor ou intensidade. Uma analogia útil é pensar no desenho vetorial como uma receita geométrica, enquanto a imagem raster é o prato já servido em uma malha de células. Rasterizar significa converter a receita em amostras visíveis, decidindo quais pixels serão acesos e com que intensidade.
As transformações básicas são translação, escala e rotação. Em 2D, um ponto pode ser representado por \( (x, y) \); em 3D, por \( (x, y, z) \). O problema é que a translação não pode ser escrita como simples multiplicação por uma matriz \( 2 \times 2 \) ou \( 3 \times 3 \) aplicada diretamente às coordenadas cartesianas, porque ela exige um termo constante adicional. É por isso que entram as coordenadas homogêneas: adicionamos uma coordenada extra, normalmente igual a 1, e passamos a representar o ponto 2D por \( (x, y, 1) \) e o ponto 3D por \( (x, y, z, 1) \).
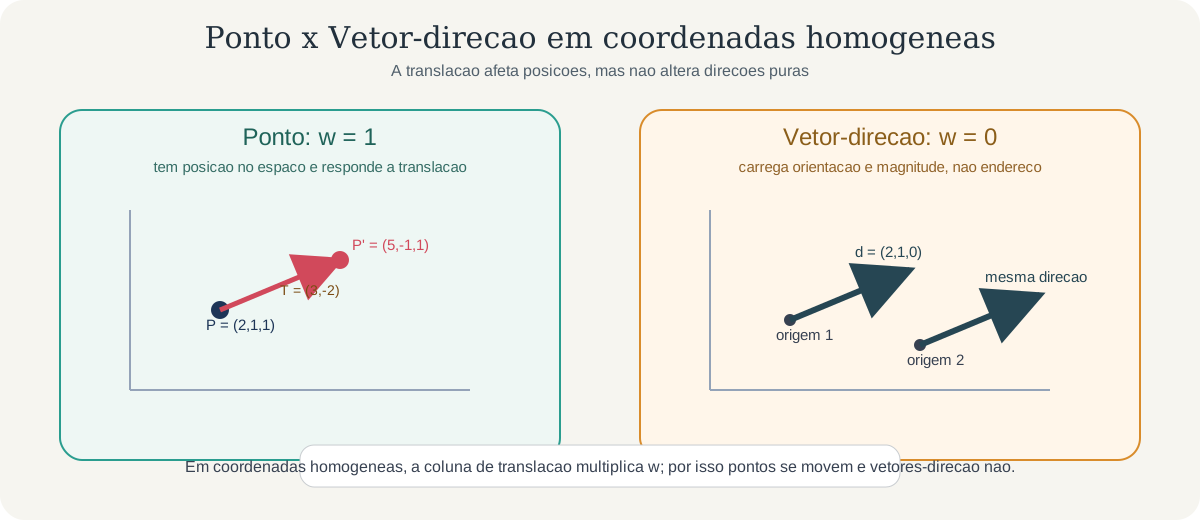
Essa extensão também ajuda a distinguir dois objetos geométricos diferentes: pontos e vetores-direção. Um ponto representa uma posição no espaço, isto é, um lugar onde algo está. Já um vetor-direção representa deslocamento, orientação ou velocidade, isto é, “para onde” e “quanto” algo aponta, mas não um endereço próprio. Em coordenadas homogêneas, um ponto usa \( w = 1 \), enquanto uma direção usa \( w = 0 \). Isso faz sentido geometricamente: uma direção pode ser rotacionada ou escalada, mas não deve ser deslocada por uma translação, porque direção não mora em lugar nenhum.
Considere, por exemplo, um ponto \( P = (2, 1, 1)^T \) e um vetor-direção \( d = (2, 1, 0)^T \). Se aplicamos uma translação de \( (3, -2) \), o ponto passa a \( (5, -1, 1)^T \), porque sua posição mudou. Já o vetor-direção continua apontando para a mesma orientação relativa, permanecendo \( (2, 1, 0)^T \). Essa diferença é crucial em computação gráfica: posições de vértices mudam com translação, mas normais, tangentes e direções de movimento não devem ser alteradas pelo simples deslocamento do objeto.
Didaticamente, vale a analogia com uma etiqueta de endereço: os componentes usuais dizem “onde” está o ponto, e a coordenada homogênea permite embutir no mesmo operador tanto giros e escalas quanto a mudança de endereço produzida pela translação. Para um vetor-direção, essa etiqueta está ausente; ele carrega orientação e magnitude, mas não localização.
Essa distinção aparece claramente em código. Em Python com NumPy, podemos aplicar a mesma matriz de translação a um ponto e a um vetor-direção:
import numpy as np

T = np.array([
    [1, 0, 3],
    [0, 1, -2],
    [0, 0, 1]
])

ponto = np.array([2, 1, 1])
direcao = np.array([2, 1, 0])

print(T @ ponto)    # [ 5 -1  1]
print(T @ direcao)  # [2 1 0]
Em 3D, a mesma ideia aparece em bibliotecas de álgebra linear usadas em motores gráficos:
glm::vec4 ponto(2.0f, 1.0f, 0.0f, 1.0f);
glm::vec4 direcao(2.0f, 1.0f, 0.0f, 0.0f);

glm::mat4 T = glm::translate(glm::mat4(1.0f), glm::vec3(3.0f, -2.0f, 5.0f));

glm::vec4 pontoTransformado = T * ponto;
glm::vec4 direcaoTransformada = T * direcao;
A translação é a transformação mais intuitiva: todos os pontos do objeto são deslocados pela mesma quantidade e na mesma direção. Se movemos um triângulo 5 unidades para a direita e 2 para cima, cada um de seus vértices sofre exatamente esse mesmo deslocamento. Por isso, a translação preserva forma, tamanho, ângulos e paralelismo; ela apenas altera a posição do objeto no espaço. Em animação, essa operação aparece o tempo todo: mover um personagem pela cena, deslocar a câmera, arrastar um ícone na tela ou reposicionar uma janela são, do ponto de vista geométrico, casos de translação.
Em 2D, a translação por \( (t_x, t_y) \) fica:
$$ \begin{bmatrix} x' \\ y' \\ 1 \end{bmatrix} = \begin{bmatrix} 1 & 0 & t_x \\ 0 & 1 & t_y \\ 0 & 0 & 1 \end{bmatrix} \begin{bmatrix} x \\ y \\ 1 \end{bmatrix}. $$A escala em 2D é dada por:
$$ \begin{bmatrix} x' \\ y' \\ 1 \end{bmatrix} = \begin{bmatrix} s_x & 0 & 0 \\ 0 & s_y & 0 \\ 0 & 0 & 1 \end{bmatrix} \begin{bmatrix} x \\ y \\ 1 \end{bmatrix}. $$Já a rotação em torno da origem é:
$$ \begin{bmatrix} x' \\ y' \\ 1 \end{bmatrix} = \begin{bmatrix} \cos \theta & -\sin \theta & 0 \\ \sin \theta & \cos \theta & 0 \\ 0 & 0 & 1 \end{bmatrix} \begin{bmatrix} x \\ y \\ 1 \end{bmatrix}. $$Um exemplo simples ajuda a fixar a mecânica. Se \( P = (2, 1, 1)^T \) e aplicamos uma translação de \( (3, -2) \), obtemos \( P' = (5, -1, 1)^T \). Se depois rotacionamos esse resultado em \( 90^\circ \) no sentido anti-horário, chegamos a \( P'' = (1, 5, 1)^T \). A ordem importa: rotacionar antes de transladar produz outro ponto. Essa sensibilidade é central em animação, modelagem hierárquica e manipulação de câmera.
Quando várias transformações são encadeadas, podemos combiná-las em uma única matriz. Se primeiro aplicamos \( M_1 \) e depois \( M_2 \), o resultado é \( P' = M_2 M_1 P \). Essa regra parece apenas algébrica, mas tem consequência prática importante: mudar a ordem muda o resultado. Em modelagem, isso explica por que “girar e depois mover” não é equivalente a “mover e depois girar”.
Em 3D, o raciocínio é o mesmo, mas usamos matrizes \( 4 \times 4 \). A translação fica:
$$ \begin{bmatrix} x' \\ y' \\ z' \\ 1 \end{bmatrix} = \begin{bmatrix} 1 & 0 & 0 & t_x \\ 0 & 1 & 0 & t_y \\ 0 & 0 & 1 & t_z \\ 0 & 0 & 0 & 1 \end{bmatrix} \begin{bmatrix} x \\ y \\ z \\ 1 \end{bmatrix}. $$A escala em 3D é:
$$ \begin{bmatrix} x' \\ y' \\ z' \\ 1 \end{bmatrix} = \begin{bmatrix} s_x & 0 & 0 & 0 \\ 0 & s_y & 0 & 0 \\ 0 & 0 & s_z & 0 \\ 0 & 0 & 0 & 1 \end{bmatrix} \begin{bmatrix} x \\ y \\ z \\ 1 \end{bmatrix}. $$Para rotação em torno do eixo \( x \), temos:
$$ R_x(\theta)= \begin{bmatrix} 1 & 0 & 0 & 0 \\ 0 & \cos \theta & -\sin \theta & 0 \\ 0 & \sin \theta & \cos \theta & 0 \\ 0 & 0 & 0 & 1 \end{bmatrix}. $$Em torno do eixo \( y \):
$$ R_y(\theta)= \begin{bmatrix} \cos \theta & 0 & \sin \theta & 0 \\ 0 & 1 & 0 & 0 \\ -\sin \theta & 0 & \cos \theta & 0 \\ 0 & 0 & 0 & 1 \end{bmatrix}. $$Em torno do eixo \( z \):
$$ R_z(\theta)= \begin{bmatrix} \cos \theta & -\sin \theta & 0 & 0 \\ \sin \theta & \cos \theta & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 1 \end{bmatrix}. $$Um exemplo 3D curto ajuda a tornar isso menos abstrato. Se \( Q = (1, 2, 3, 1)^T \), aplicamos uma escala com \( s_x = 2 \), \( s_y = 1 \) e \( s_z = 1 \), obtemos \( (2, 2, 3, 1)^T \). Se depois translacionamos por \( (1, 0, -2) \), chegamos a \( (3, 2, 1, 1)^T \). Em uma aplicação real, essa cadeia pode descrever um personagem sendo redimensionado, posicionado na cena e orientado antes de passar às transformações de câmera e projeção.
É importante separar dois níveis da discussão. Nesta seção, estamos tratando da transformação geométrica do objeto em si. Mais adiante, essas matrizes serão combinadas com as matrizes de visualização e projeção, formando cadeias como \( M_{proj} M_{view} M_{model} \). Ou seja, primeiro colocamos o objeto no mundo, depois colocamos o mundo no referencial da câmera e só então projetamos tudo na tela.
Depois de descrever objetos em coordenadas locais e posicioná-los no mundo, ainda falta responder a uma pergunta prática: que parte dessa cena realmente será mostrada ao usuário e em que região da tela ela aparecerá? É aqui que entram os sistemas de coordenadas 2D de visualização e o recorte. Em termos simples, não basta saber onde um objeto está no plano; é preciso decidir qual trecho do “mundo” será observado e como esse trecho será encaixado no dispositivo de saída.
Em uma formulação clássica, distinguimos pelo menos quatro níveis. O objeto pode nascer em coordenadas locais. Depois ele é colocado em coordenadas de mundo, que representam uma cena mais ampla. Em seguida escolhemos uma janela de visualização, isto é, uma região do mundo que queremos observar. Por fim, esse conteúdo é mapeado para uma viewport, a área retangular do dispositivo onde a imagem será desenhada. A janela está no espaço da cena; a viewport está no espaço da tela.
Uma analogia útil é pensar em um mapa sobre a mesa. O mundo é o mapa inteiro. A janela é a parte enquadrada por uma moldura transparente colocada sobre ele. A viewport é a área da tela ou do monitor onde esse enquadramento será exibido. Essa distinção é central em interfaces gráficas, jogos 2D, minimapas, editores de imagem, sistemas de desenho assistido por computador e visualização de dados.
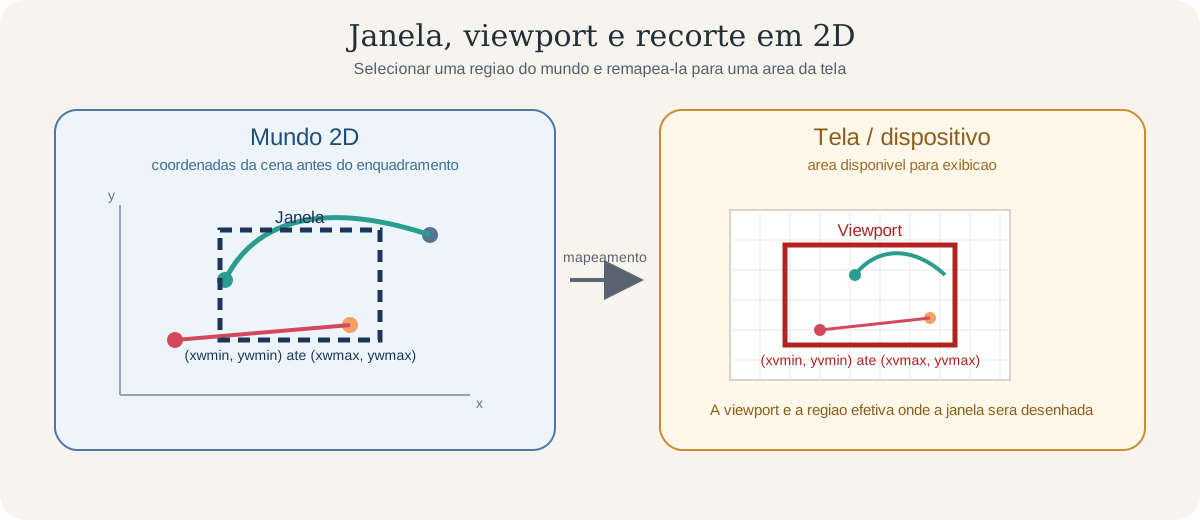
Se a janela no mundo vai de \( (x_{wmin}, y_{wmin}) \) até \( (x_{wmax}, y_{wmax}) \) e a viewport vai de \( (x_{vmin}, y_{vmin}) \) até \( (x_{vmax}, y_{vmax}) \), o mapeamento pode ser escrito como:
$$ x_v = x_{vmin} + \frac{x_w - x_{wmin}}{x_{wmax} - x_{wmin}} (x_{vmax} - x_{vmin}), $$ $$ y_v = y_{vmin} + \frac{y_w - y_{wmin}}{y_{wmax} - y_{wmin}} (y_{vmax} - y_{vmin}). $$Essas expressões dizem algo simples: primeiro localizamos a posição relativa do ponto dentro da janela e depois transportamos essa mesma proporção para a viewport. Em outras palavras, trata-se de uma combinação de translação e escala. Se a janela tiver proporção diferente da viewport, o objeto pode parecer esticado; por isso, muitos sistemas tentam preservar a razão de aspecto ou introduzem margens para evitar deformação.
Um exemplo curto ajuda a concretizar a conta. Suponha uma janela de mundo de \( (0,0) \) até \( (100,100) \) e uma viewport na tela de \( (0,0) \) até \( (800,600) \). Um ponto do mundo em \( (25,40) \) será mapeado para \( (200,240) \). O raciocínio é direto: \( 25 \) corresponde a um quarto da largura da janela, então ocupa um quarto da largura da viewport; \( 40 \) corresponde a 40% da altura da janela, então ocupa 40% da altura da viewport. Esse tipo de cálculo aparece o tempo todo em bibliotecas 2D, interfaces responsivas e sistemas de câmeras em jogos.
Em uma implementação real, essa conta muitas vezes aparece de forma explícita no código. Em uma biblioteca 2D, por exemplo, o remapeamento pode ser escrito como:
def world_to_viewport(xw, yw,
                      xwmin, ywmin, xwmax, ywmax,
                      xvmin, yvmin, xvmax, yvmax):
    xv = xvmin + (xw - xwmin) * (xvmax - xvmin) / (xwmax - xwmin)
    yv = yvmin + (yw - ywmin) * (yvmax - yvmin) / (ywmax - ywmin)
    return xv, yv
Essa forma operacional ajuda a enxergar um ponto importante: o mapeamento janela-viewport é uma etapa de normalização. A ideia de normalizar coordenadas aparece repetidamente em computação gráfica porque permite trabalhar primeiro em um sistema intermediário mais estável e só depois adaptar o resultado ao tamanho real da tela. Em APIs modernas, essa intuição reaparece nas coordenadas de dispositivo normalizadas, ou normalized device coordinates, em que a geometria válida é trazida para um domínio canônico antes da transformação final para coordenadas de janela.
Esse domínio canônico facilita muito o pipeline. Em vez de cada etapa precisar conhecer diretamente o tamanho físico de cada tela ou janela, várias decisões são tomadas em um espaço intermediário padronizado. Só depois a viewport faz a adaptação ao dispositivo efetivo. Do ponto de vista de engenharia, isso melhora portabilidade, simplifica a composição entre etapas e permite suportar desde pequenas janelas em interfaces até renderização em tela cheia, múltiplos monitores e múltiplas viewports na mesma aplicação.
Mas antes mesmo de mapear tudo para a tela, surge um problema de eficiência e consistência visual: o que fazer com objetos que estão total ou parcialmente fora da janela? Esse processo é o recorte, ou clipping. Em vez de rasterizar toda a geometria e só depois descartar o que não será visto, vale mais a pena eliminar cedo o que certamente não aparecerá e aparar o que cruza a fronteira visível.
No caso de segmentos de reta, a literatura clássica produziu algoritmos bastante elegantes. O Cohen-Sutherland associa a cada extremidade um código binário indicando se o ponto está acima, abaixo, à esquerda ou à direita da janela. Isso permite aceitar rapidamente uma reta totalmente interna, rejeitar uma totalmente externa ou localizar trechos que precisam ser cortados. Já o Liang-Barsky usa uma formulação paramétrica da reta e costuma ser mais econômico em interseções, pois trabalha diretamente com o intervalo válido do parâmetro \( t \).
Para polígonos, a ideia se generaliza: mantemos apenas a porção da figura que permanece dentro da região visível. Historicamente, algoritmos como Sutherland-Hodgman foram importantes nesse contexto. Mas livros clássicos de computação gráfica mostram que o problema vai além de linhas e polígonos: também surgem versões de clipping para círculos, elipses, curvas spline e até texto rasterizado. Isso importa porque interfaces gráficas reais raramente exibem apenas segmentos; elas exibem bordas curvas, ícones, glifos e objetos compostos.
Outro subtópico importante é distinguir clipping de culling. No clipping, cortamos geometricamente a parte do objeto que cruza a fronteira visível. No culling, descartamos inteiramente um objeto porque sabemos de antemão que ele não precisa seguir adiante no pipeline. Em jogos e engines, essa diferença é prática: um objeto completamente fora da câmera pode ser removido por culling; uma aresta que atravessa parcialmente a região visível precisa de clipping. Misturar esses conceitos costuma gerar confusão porque ambos “eliminam coisas”, mas em níveis diferentes.
A razão de aspecto também merece destaque porque conecta diretamente geometria e percepção. Se a janela representa um quadrado do mundo, mas a viewport é muito mais larga do que alta, um círculo pode parecer elipse e um personagem pode parecer achatado. Em sistemas interativos, isso é tratado com estratégias como letterboxing, pillarboxing ou ajuste dinâmico de câmera. Em visualização científica e CAD, a preservação correta da escala pode ser ainda mais importante do que o preenchimento completo da tela.
Nos pipelines atuais, o recorte não é apenas um detalhe histórico. Ele ajuda a reduzir custo de rasterização, evita artefatos em primitivas muito grandes e prepara a cena para a etapa seguinte, na qual a geometria será normalizada dentro de um volume canônico. Em interfaces modernas, isso aparece em painéis roláveis, janelas sobrepostas e renderização parcial de componentes; em engines de jogos, aparece em câmeras, minimapas, HUDs, múltiplas viewports e renderização de cenas diferentes para regiões distintas da mesma tela. Em bibliotecas gráficas e sistemas de janelas, esse mesmo princípio aparece no gerenciamento de regiões de desenho válidas, áreas expostas e superfícies parcialmente cobertas.
A janela escolhe o que observar; a viewport decide onde mostrar; o recorte impede trabalho inútil e garante coerência visual. Essa cadeia prepara o terreno para a próxima etapa: entender como o espaço tridimensional será projetado em uma imagem bidimensional.
Projetar significa converter pontos de um espaço de maior dimensão em outro de menor dimensão preservando, tanto quanto possível, a informação visual que interessa. Em computação gráfica, o caso mais comum é levar pontos 3D para um plano 2D. Essa operação inevitavelmente introduz alguma perda ou distorção, e o tipo de projeção escolhido determina quais relações geométricas serão preservadas e quais serão sacrificadas em favor da percepção visual.
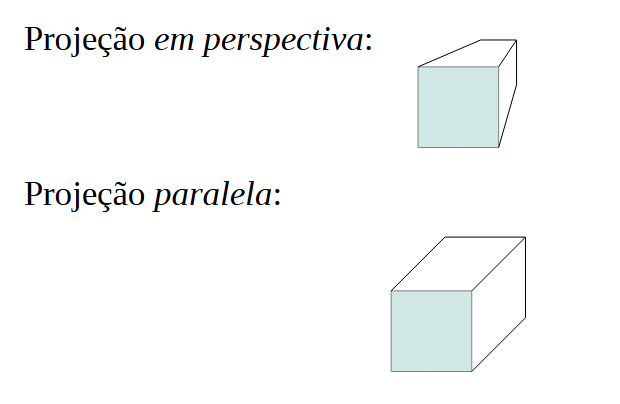
Historicamente, esse tema se desenvolveu em duas frentes muito ligadas a aplicações diferentes. Em desenho técnico, arquitetura e CAD, interessava preservar medidas e paralelismo para facilitar inspeção geométrica. Em pintura, fotografia, cinema e depois jogos digitais, interessava reproduzir a sensação de profundidade observada por um espectador. É desse contraste que nascem as duas grandes famílias: projeção paralela e projeção em perspectiva.
Na projeção paralela, os raios projetantes são paralelos entre si. Isso significa que não existe convergência visual para um centro de projeção finito. A principal vantagem é geométrica: retas paralelas no espaço tendem a permanecer paralelas na imagem, o que facilita leitura técnica e medições. Por essa razão, projeções paralelas são muito usadas em engenharia, CAD, modelagem arquitetônica, mapas técnicos e certas formas de visualização científica.
Dentro dessa família, convém distinguir dois casos. Na projeção ortográfica, os raios são perpendiculares ao plano de projeção; é o caso mais comum em vistas frontal, superior e lateral. Já na projeção oblíqua, os raios continuam paralelos entre si, mas incidem com um ângulo diferente de \( 90^\circ \) em relação ao plano de projeção. Isso permite exibir mais de uma face do objeto simultaneamente, ao custo de uma deformação visual controlada. Em aplicações didáticas e certos esquemas de desenho, esse compromisso pode ser útil.
Em uma forma ortográfica simples, projetar um ponto \( (x, y, z) \) no plano significa essencialmente manter as componentes \( x \) e \( y \) e desprezar a profundidade visual na etapa da imagem:
$$ \begin{bmatrix} x_{img} \\ y_{img} \\ 1 \end{bmatrix} = \begin{bmatrix} 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 0 & 1 \end{bmatrix} \begin{bmatrix} x \\ y \\ z \\ 1 \end{bmatrix}. $$Em implementações práticas, a forma mais útil é a matriz de projeção ortográfica normalizada, que também leva em conta os limites da janela de visão. Uma escrita comum é:
$$ M_{ortho} = \begin{bmatrix} \frac{2}{r-l} & 0 & 0 & -\frac{r+l}{r-l} \\ 0 & \frac{2}{t-b} & 0 & -\frac{t+b}{t-b} \\ 0 & 0 & -\frac{2}{f-n} & -\frac{f+n}{f-n} \\ 0 & 0 & 0 & 1 \end{bmatrix}, $$em que \( l \), \( r \), \( b \), \( t \), \( n \) e \( f \) representam, respectivamente, os limites esquerdo, direito, inferior, superior, próximo e distante do volume de visão. A presença desses parâmetros mostra que projetar não é apenas “apagar o eixo \( z \)”, mas também normalizar o que será mantido dentro de um domínio geométrico controlado.
Já na projeção em perspectiva, os raios convergem para um centro de projeção. Esse detalhe muda profundamente a imagem: objetos distantes parecem menores, linhas paralelas podem convergir visualmente e a profundidade torna-se perceptível. Essa é a projeção que mais se aproxima da maneira como câmeras e observadores humanos percebem o espaço, razão pela qual domina jogos 3D, simuladores, ambientes imersivos e visualização interativa.
No modelo de câmera pinhole, assumindo uma câmera alinhada ao eixo óptico e um plano de imagem descrito por uma distância focal \( f \), a intuição matemática da perspectiva aparece na relação:
$$ x_{img} = f \frac{x}{z}, \qquad y_{img} = f \frac{y}{z}. $$Aqui, \( x \), \( y \) e \( z \) são coordenadas do ponto no referencial da câmera. Quanto maior o valor de \( z \), menor a projeção do ponto no plano da imagem. É por isso que objetos distantes parecem menores. O efeito visual dos pontos de fuga não é um truque artístico adicionado no fim do processo; ele é uma consequência geométrica direta da divisão pela profundidade.
Quando passamos da geometria intuitiva para o pipeline gráfico, a perspectiva deixa de ser tratada apenas como razão \( x/z \) e \( y/z \) e passa a ser embutida em uma matriz de projeção. Uma forma canônica, usada para um frustum simétrico, é:
$$ M_{persp} = \begin{bmatrix} \frac{1}{a \tan(\theta/2)} & 0 & 0 & 0 \\ 0 & \frac{1}{\tan(\theta/2)} & 0 & 0 \\ 0 & 0 & \frac{f+n}{n-f} & \frac{2fn}{n-f} \\ 0 & 0 & -1 & 0 \end{bmatrix}, $$em que \( \theta \) é o campo de visão vertical, \( a \) é a razão de aspecto da imagem, \( n \) é o plano próximo e \( f \) é o plano distante. Os dois primeiros termos controlam abertura angular da câmera; os dois seguintes empacotam a profundidade no espaço de recorte. É a presença da linha final \( (0,0,-1,0) \) que prepara a divisão homogênea responsável pelo efeito de perspectiva.
Nos pipelines baseados em matrizes, a cadeia geométrica pode ser resumida assim: o ponto sai do espaço da câmera, entra no volume de visão, é transformado em coordenadas de recorte, sofre a divisão homogênea e só então vai para coordenadas normalizadas e, depois, para a viewport. Em notação de etapas, isso pode ser pensado como:
$$ p_{clip} = M_{proj} \, p_{view}, \qquad p_{ndc} = \frac{1}{w_c} p_{clip}. $$Escrevendo coordenada a coordenada, obtemos:
$$ x_{ndc} = \frac{x_c}{w_c}, \qquad y_{ndc} = \frac{y_c}{w_c}, \qquad z_{ndc} = \frac{z_c}{w_c}. $$Aqui, o subscrito \( c \) indica coordenadas de recorte e \( ndc \) indica coordenadas de dispositivo normalizadas. Essa divisão é o coração geométrico da perspectiva. Sem ela, a cena manteria escala constante como em uma projeção ortográfica. Em outras palavras, a matriz sozinha prepara o problema; a divisão por \( w_c \) produz o efeito visual que o observador percebe como profundidade.
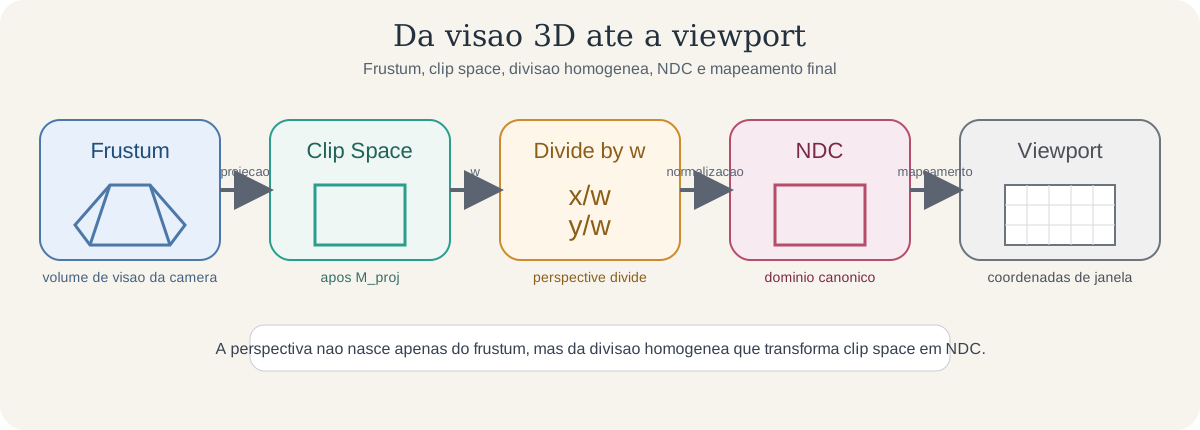
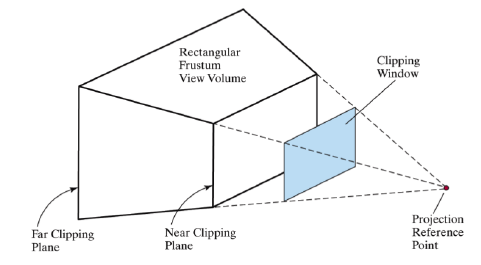
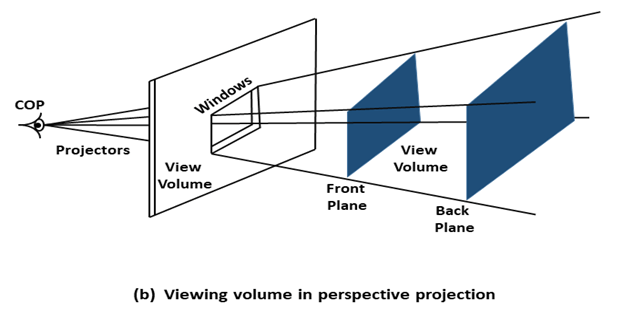
O volume visível em perspectiva é um frustum: um tronco de pirâmide limitado por um plano próximo e um plano distante. Esses dois planos afetam não só o que pode ser visto, mas também a precisão do buffer de profundidade. Essa precisão não é distribuída uniformemente: ela se concentra mais perto do plano próximo. Por isso, escolher um plano próximo excessivamente pequeno pode degradar a qualidade da comparação em profundidade e aumentar a chance de z-fighting, artefato em que superfícies quase coplanares competem pela mesma profundidade aparente.
Esse ponto tem implicação prática direta. Em um simulador ou jogo, usar \( n = 0{,}001 \) e \( f = 10000 \) parece dar liberdade para “ver tudo”, mas piora a estabilidade numérica do sistema de profundidade. Em geral, vale mais a pena afastar o plano próximo o quanto for aceitável e evitar razões extremas entre \( f \) e \( n \). Aqui aparece uma relação importante entre matemática e projeto visual: campo de visão, profundidade e percepção não são parâmetros independentes; ajustar um deles afeta os outros.
Um exemplo computacional resume bem a diferença entre os dois tipos de projeção em bibliotecas modernas:
glm::mat4 ortho = glm::ortho(-10.0f, 10.0f, -7.5f, 7.5f, 0.1f, 100.0f);
glm::mat4 persp = glm::perspective(glm::radians(60.0f), 16.0f / 9.0f, 0.1f, 100.0f);
No primeiro caso, o tamanho aparente do objeto não depende da distância ao observador da mesma forma que na visão humana. No segundo, a abertura angular de \( 60^\circ \) e a razão de aspecto \( 16/9 \) definem um campo visual mais próximo do que esperamos em um ambiente imersivo. É exatamente por isso que interfaces CAD, mapas técnicos e reconstruções médicas frequentemente preferem ortográfica para medições, enquanto jogos, simuladores e navegação virtual usam perspectiva para comunicar melhor escala relativa, distância e orientação espacial.
A câmera virtual é o modelo matemático que transforma uma cena 3D em imagem. Em vez de falar apenas em "olhar para o objeto", a computação gráfica descreve a câmera por parâmetros. Os parâmetros intrínsecos explicam como a imagem é formada dentro do sensor ou plano da imagem; os extrínsecos dizem onde a câmera está e para onde ela aponta no mundo.
Uma forma compacta de escrever essa ideia é:
$$ \lambda \begin{bmatrix} u \\ v \\ 1 \end{bmatrix} = K \begin{bmatrix} R & t \end{bmatrix} \begin{bmatrix} X \\ Y \\ Z \\ 1 \end{bmatrix}, $$em que \( K \) contém distância focal e ponto principal, enquanto \( R \) e \( t \) definem orientação e translação da câmera. O parâmetro \( \lambda \) aparece porque estamos em coordenadas homogêneas. Esse modelo vale tanto para motores 3D quanto para visão computacional e realidade aumentada.
Uma explicação didática útil é pensar que a câmera tem duas tarefas diferentes. Primeiro ela traduz a cena para o "idioma" do observador: o que está à direita da câmera continua à direita, o que está atrás dela deve ser descartado. Depois ela transforma profundidade em tamanho aparente. Quando essas duas tarefas são confundidas, o estudante costuma decorar matrizes sem entender o que cada uma realmente faz.
Em aplicações modernas, calibrar a câmera deixou de ser detalhe de laboratório. Um filtro de realidade aumentada precisa conhecer a distância focal em pixels para que o objeto virtual não deslize sobre a mesa; um sistema de reconstrução 3D precisa combinar câmeras com extrínsecos coerentes; um simulador de direção precisa ajustar campo de visão para que velocidade e distância pareçam plausíveis ao usuário.
Em uma cena 3D realista, quase nada é descrito diretamente em coordenadas de tela. Cada objeto nasce em seu sistema local, e só depois percorre uma sequência de mudanças de referencial: local para mundo, mundo para câmera, câmera para recorte e recorte para tela. Essa cadeia organiza o problema e permite reaproveitar geometria em várias posições e orientações.
Uma forma prática de resumir isso é com a matriz \( MVP \):
$$ p_{clip} = M_{proj} M_{view} M_{model} p_{local}. $$A matriz \( M_{model} \) posiciona o objeto no mundo. A matriz \( M_{view} \) coloca o mundo no referencial da câmera. A matriz \( M_{proj} \) gera as coordenadas de recorte que depois sofrerão divisão homogênea e mapeamento para a viewport.
Em APIs modernas, esse encadeamento aparece quase literalmente no código:
glm::mat4 model = ...;
glm::mat4 view = glm::lookAt(eye, target, up);
glm::mat4 projection = glm::perspective(fovy, aspect, zNear, zFar);
glm::mat4 mvp = projection * view * model;

glUniformMatrix4fv(locMVP, 1, GL_FALSE, glm::value_ptr(mvp));
Esse pequeno trecho condensa uma ideia profunda: o mesmo vértice pode ser interpretado em vários contextos. Um cubo unitário modelado em torno da origem pode virar um prédio, uma caixa de colisão ou um marcador de interface, dependendo das transformações aplicadas.
Há ainda um cuidado matemático que costuma ser negligenciado em introduções muito rápidas. Vetores normais não devem ser transformados exatamente como posições quando há escala não uniforme. Nesses casos, usa-se a inversa transposta da parte linear da matriz de modelagem. Sem isso, a iluminação parece errada mesmo quando a geometria está no lugar correto. Esse detalhe conecta álgebra linear, geometria diferencial elementar e implementação prática de shaders.
Outro ponto importante é a convenção de orientação do sistema, como mão direita ou mão esquerda. A escolha afeta o sentido positivo de rotações, a interpretação do eixo de profundidade e o descarte de faces traseiras. Engines diferentes podem adotar convenções distintas; por isso, importar modelos de fontes diversas sem normalizar coordenadas é uma causa comum de objetos invertidos, escalas inconsistentes e normais apontando para dentro.
Grande parte da geometria usada em computação gráfica é representada por malhas poligonais, em especial malhas triangulares. Triângulos são estáveis, sempre coplanares e convenientemente processados por hardware. Um objeto complexo, como um personagem ou um carro, vira uma coleção organizada de vértices, arestas implícitas, faces, normais e coordenadas de textura.
O formato OBJ popularizou uma forma simples de armazenar parte dessas informações:
v 1.0000 -1.0000 -1.0000
v 1.0000 -1.0000  1.0000
v -1.0000 -1.0000 1.0000
vt 0.0 0.0
vn 0.0 1.0 0.0
f 5/1/1 1/2/1 4/3/1
Nesse exemplo, v indica vértice, vt coordenada de textura, vn normal e f face. Em pipelines contemporâneos, formatos como glTF costumam ser preferidos para distribuição porque carregam melhor materiais, animações e dados compactados, mas a ideia estrutural continua sendo a mesma: uma malha é uma discretização da superfície.
Ao definir uma cena, não basta armazenar pontos. É preciso também decidir conectividade, orientação de faces, suavização de normais e nível de detalhe. Em malhas muito densas, o custo de memória, transferência e rasterização cresce rapidamente; em malhas muito pobres, o objeto perde silhueta e apresenta facetas visíveis. O problema moderno não é apenas "desenhar o objeto", mas fazê-lo com resolução adequada para o dispositivo, para a distância ao observador e para o orçamento de tempo por quadro.
Quando a entrada é um conjunto de amostras no plano ou uma nuvem de pontos quase regular, triangulações baseadas em critérios geométricos ajudam a evitar triângulos excessivamente finos. A intuição por trás de abordagens desse tipo é maximizar qualidade local da malha para melhorar interpolação, simulação e renderização. Em terrenos, reconstruções a partir de sensores e superfícies amostradas, isso faz diferença prática.
Também é aqui que entram coordenadas baricêntricas e interpolação sobre triângulos. Se uma cor, uma normal ou uma coordenada UV é conhecida nos vértices, podemos estendê-la para qualquer ponto interno da face por combinação linear. Esse mecanismo aparece em textura, sombreamento e testes de inclusão ponto-triângulo, mostrando como um conceito matemático simples reaparece em várias etapas do pipeline.
Renderizar é transformar uma descrição abstrata da cena em uma imagem. Historicamente, isso foi feito primeiro em software e depois com aceleração massiva por GPU. Em termos conceituais, porém, a estrutura continua reconhecível: recebemos vértices e estados de material, processamos geometria, decidimos visibilidade, calculamos cor e gravamos o resultado em um framebuffer.
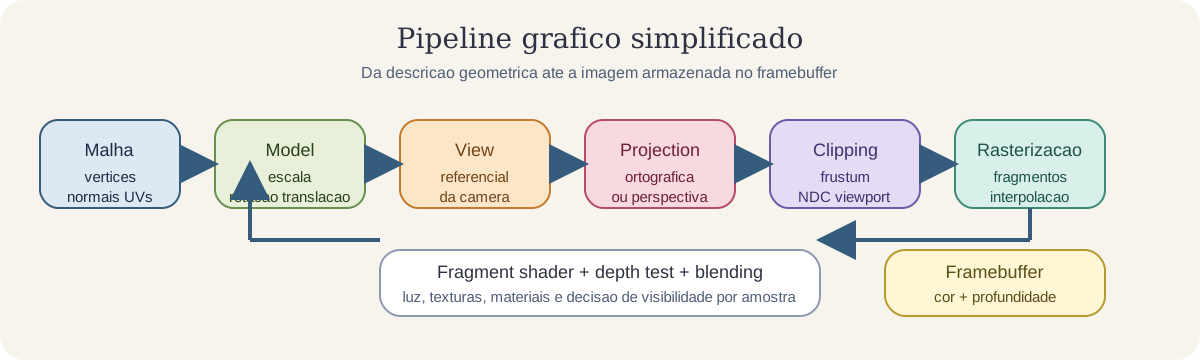
Uma decomposição útil do pipeline inclui: especificação de vértices, transformações geométricas, montagem de primitivas, recorte, rasterização, sombreamento de fragmentos e testes por amostra, como profundidade e mistura de cores. Em pipelines programáveis, vertex shaders e fragment shaders permitem customizar partes essenciais desse fluxo. Em pipelines híbridos recentes, também é possível mesclar rasterização e ray tracing para sombras, reflexos ou iluminação global.
A remoção de superfícies ocultas costuma ser feita com z-buffer. Cada fragmento gerado pela rasterização carrega um valor de profundidade e só substitui o que já está no framebuffer se passar no teste correspondente. A ideia parece simples, mas resolve um problema que atormentou os primeiros renderizadores: determinar qual polígono realmente está na frente sem ordenar toda a cena manualmente. Em tempo real, esse mecanismo continua central.
Na iluminação local, um modelo bastante usado em cursos introdutórios combina termos ambiente, difuso e especular. Sobre essa base, surgem diferentes técnicas de tonalização. No sombreamento plano, uma face inteira recebe uma única resposta de luz; no de Gouraud, a iluminação é calculada nos vértices e interpolada; no de Phong, interpolam-se normais e a iluminação é avaliada por fragmento. O último custa mais, mas reduz artefatos especulares e melhora a suavidade aparente.
Um fragment shader mínimo para iluminação difusa pode parecer com isto:
vec3 N = normalize(normal);
vec3 L = normalize(lightDir);
float ndotl = max(dot(N, L), 0.0);
vec3 color = albedo * (0.1 + ndotl);
Mesmo esse exemplo compacto já expressa duas ideias matemáticas importantes: o produto escalar mede alinhamento angular e a normalização evita que o comprimento dos vetores contamine o resultado. A partir daqui, pipelines modernos adicionam sombras, mapas normais, BRDFs fisicamente inspiradas, amostragem estocástica e técnicas temporais.
Vale distinguir rasterização de ray tracing. Rasterização é extremamente eficiente para converter triângulos em fragmentos; ray tracing é excelente para modelar visibilidade complexa, como reflexos múltiplos e refrações. O estado da arte em tempo real combina ambos, explorando hardware especializado sem abandonar a estrutura tradicional do pipeline.
Aplicar textura é mapear dados 2D sobre uma superfície 3D. A intuição mais simples é imaginar um papel estampado sendo colado sobre um objeto. A dificuldade real está em abrir ou envolver a superfície sem distorções excessivas e em amostrar a imagem corretamente quando ela aparece ampliada, reduzida ou inclinada em relação à câmera.
As coordenadas de textura costumam ser dadas por pares \( (u, v) \) no intervalo \( [0, 1] \). Elas dizem que parte da imagem corresponde a cada vértice da malha. Durante a rasterização, esses valores são interpolados pelos fragmentos para localizar o texel adequado. Planos, cilindros, esferas e cubos costumam exigir parametrizações diferentes, e nenhuma delas é universalmente perfeita.
Quando o polígono ocupa mais área na tela do que a textura oferece em detalhes, ocorre magnificação; quando ocupa menos, ocorre minificação. Filtrar corretamente esses casos é essencial. O modo nearest escolhe a amostra mais próxima e pode produzir aspecto serrilhado ou pixelizado. A filtragem bilinear suaviza a amostragem local, a trilinear interpola também entre níveis de mipmap, e a filtragem anisotrópica melhora bastante superfícies vistas em ângulos rasantes, como estradas e pisos.
Mipmaps são versões progressivamente menores da mesma textura. Eles reduzem aliasing e melhoram desempenho porque evitam consultar uma imagem de alta resolução quando ela aparece minúscula em tela. Esse é outro exemplo de como um detalhe aparentemente de implementação depende de uma ideia matemática clara: escolher a escala de amostragem compatível com a frequência espacial observada.
Textura também deixou de significar apenas cor. Em pipelines modernos, mapas de normais, rugosidade, metalicidade, oclusão ambiente e deslocamento carregam propriedades visuais diferentes da superfície. Assim, boa parte do realismo atual não vem de aumentar indefinidamente o número de triângulos, mas de enriquecer como a luz interage com a geometria aparente.
Aliasing aparece quando tentamos representar um sinal contínuo com amostragem insuficiente. Em imagens, isso se manifesta como bordas em degraus, cintilação em movimento, padrões moiré e detalhes falsos. O princípio matemático por trás do problema é o mesmo do processamento de sinais: para reconstruir adequadamente uma frequência máxima \( f_{max} \), a taxa de amostragem deve satisfazer
$$ f_s \geq 2 f_{max}. $$Em computação gráfica, o desafio é que a cena pode conter frequências altas na geometria, na textura, na iluminação e até no tempo. Uma grade metálica distante, por exemplo, pode produzir forte aliasing espacial; uma câmera em movimento sobre um padrão detalhado pode gerar aliasing temporal, percebido como tremulação.
As famílias de antialiasing atacam o problema em pontos diferentes do pipeline. O supersampling amostra a cena em resolução mais alta e depois reduz; o multisampling economiza custo concentrando-se sobretudo nas bordas geométricas; filtros de tela como FXAA estimam contornos na imagem final; técnicas temporais, como TAA, reutilizam informação de quadros anteriores para estabilizar detalhe fino em movimento.
Nem toda estratégia resolve tudo. MSAA melhora serrilhado de bordas, mas não corrige aliasing oriundo de shaders ou texturas mal filtradas. TAA pode reduzir cintilação, mas introduzir ghosting se o reuso temporal for mal calibrado. Em outras palavras, aliasing não é um único defeito, e sim uma família de falhas ligadas à amostragem. Entender isso evita a expectativa errada de que exista um "botão universal" de suavização.
Visualizar não é apenas "fazer ficar bonito". Em computação gráfica, visualização é o processo de transformar estrutura, forma, profundidade, material e iluminação em uma imagem legível para um observador humano. A qualidade visual depende tanto da exatidão geométrica quanto da forma como a luz é modelada e codificada para exibição.
Um modelo clássico para introduzir iluminação local é o de Phong:
$$ I = k_a I_a + k_d I_l \max(0, \mathbf{n} \cdot \mathbf{l}) + k_s I_l \max(0, \mathbf{r} \cdot \mathbf{v})^{n_s}. $$O primeiro termo modela luz ambiente, o segundo a reflexão difusa e o terceiro o brilho especular. Ele não é fisicamente completo, mas é extremamente didático porque relaciona álgebra vetorial com fenômenos visuais intuitivos: a superfície clareia quando olha para a luz e produz realce quando a direção refletida se aproxima da câmera.
Em sistemas atuais, visualização eficaz também depende de escolha de espaço de cor, correção de gama, mapeamento de tons para HDR e desenho perceptualmente coerente de materiais. Em dados científicos, por exemplo, uma paleta ruim pode esconder variações importantes; em jogos, uma exposição incoerente pode destruir sensação de escala; em realidade virtual, erros de latência e perspectiva podem causar desconforto. O problema visual final sempre envolve percepção humana, não apenas cálculo numérico.
Tópicos de matemática relacionados
Este capítulo dialoga diretamente com álgebra linear, geometria analítica, trigonometria, geometria projetiva, interpolação, amostragem, teoria de sinais, otimização numérica e métodos probabilísticos. Produtos escalares e vetoriais aparecem em iluminação e orientação espacial; coordenadas baricêntricas sustentam interpolação em triângulos; teoria de amostragem explica aliasing; e matrizes homogêneas unificam mudanças de referencial em praticamente todo o pipeline.
Quando esses blocos matemáticos são compreendidos em conjunto, a computação gráfica deixa de parecer uma coleção de receitas isoladas. Passa a ficar claro por que a mesma linguagem de vetores, planos, mudanças de base e funções reaparece na câmera virtual, no recorte, na rasterização, no sombreamento e na filtragem.
Glossário
- Aliasing
- Artefato de amostragem insuficiente que produz serrilhado, moiré, cintilação ou detalhes falsos.
- Câmera pinhole
- Modelo idealizado de câmera que projeta pontos 3D em um plano de imagem a partir de um único centro de projeção.
- Clip space
- Espaço em que a geometria é testada contra o volume de recorte antes da divisão homogênea.
- Coordenadas homogêneas
- Representação estendida de pontos e vetores que permite expressar translações e projeções por multiplicação matricial.
- Depth buffer
- Estrutura que armazena profundidade por amostra para decidir qual fragmento está visível em cada posição.
- Fragmento
- Candidato a pixel produzido pela rasterização, ainda sujeito a testes como profundidade, stencil e blending.
- Frustum
- Volume de visão em perspectiva limitado por planos laterais, superior, inferior, próximo e distante.
- Framebuffer
- Conjunto de buffers onde a imagem final é construída, incluindo cor e frequentemente profundidade.
- Mipmap
- Conjunto de versões reduzidas de uma textura usado para filtragem e redução de aliasing em minificação.
- Normal
- Vetor perpendicular a uma superfície, fundamental para cálculos de iluminação.
- Rasterização
- Etapa que converte primitivas geométricas em fragmentos sobre uma grade discreta de amostras.
- Shader
- Programa executado na GPU para controlar etapas programáveis do pipeline, como processamento de vértices e fragmentos.
- Texel
- Elemento discreto de uma textura, análogo ao pixel no domínio da imagem 2D armazenada.
- Viewport
- Região da janela ou tela para a qual as coordenadas normalizadas são mapeadas.
- Z-fighting
- Artefato visual em que superfícies muito próximas em profundidade alternam qual parece estar na frente.
Referências:
- John F. Hughes, Andries van Dam, Morgan McGuire, David F. Sklar, James D. Foley, Steven K. Feiner e Kurt Akeley. Computer Graphics: Principles and Practice. 3rd ed. Addison-Wesley, 2013.
- Tomas Akenine-Moller, Eric Haines, Naty Hoffman, Angelo Pesce, Michal Iwanicki e Sebastien Hillaire. Real-Time Rendering. 4th ed. CRC Press, 2018.
- Peter Shirley e Steve Marschner. Fundamentals of Computer Graphics. 4th ed. CRC Press, 2021.
- InformIT - Computer Graphics: Principles and Practice (descrição e sumário)
- Real-Time Rendering - Table of Contents, Preface, Introduction, Bibliography and Index
- OpenGL Wiki - General OpenGL: Transformations
- OpenGL Wiki - Clipping FAQ
- OpenGL Wiki - Depth Test
- OpenGL Wiki - Sampler (GLSL)